// NOTE 003
Zero Trust pour l’IoT médical : construire VIGIE, et ce que ça coûte par requête
Pour mon projet de fin d’études de Master, j’ai conçu et réalisé VIGIE, un framework Zero Trust qui vérifie chaque requête d’un dispositif médical connecté, de son identité à l’état clinique du patient. Le prototype Node.js a réussi les 11 tests d’attaque et d’accès, pour environ 0,5 ms de plus par requête.
Sur cette page 8 sections
› section 1 / 8
Pourquoi on ne peut pas faire confiance au réseau de l’hôpital
Un capteur de glycémie envoie ses mesures en MQTT. Une pompe à perfusion reçoit ses consignes depuis le poste infirmier. Un équipement d’imagerie dépose ses clichés dans le système d’information de l’hôpital. Ces dispositifs forment l’Internet des Objets Médicaux (IoMT), et beaucoup de réseaux hospitaliers les protègent encore à l’ancienne : un pare-feu autour du bâtiment, et une confiance implicite pour tout ce qui est déjà à l’intérieur.
Ce modèle ne tient plus face à la façon dont ces dispositifs sont utilisés. Ils changent de segment réseau, et vont parfois jusqu’au domicile du patient. Ils parlent des protocoles différents (MQTT, CoAP, HTTP/2), avec des capacités cryptographiques inégales. La plupart sont trop petits pour faire tourner l’agent de sécurité qu’on installerait sur un poste de travail. Leurs protocoles savent chiffrer le canal, mais rien n’y prouve que l’appareil à l’autre bout est bien le vrai capteur. Une fois le périmètre franchi, un attaquant circule librement.
L’enjeu dépasse la fuite de données. Une pompe à perfusion compromise peut modifier un traitement en cours.
La question de départ
Le Zero Trust, tel que le définit le référentiel NIST SP 800-207, supprime l’idée d’un intérieur sûr : chaque requête est authentifiée, autorisée et surveillée, d’où qu’elle vienne. Les travaux publiés avaient déjà recensé les techniques et en avaient appliqué une partie à la santé. Je n’ai pas trouvé de chaîne complète et exécutable, de l’enregistrement d’un dispositif jusqu’à la détection de son comportement anormal, et très peu de propositions utilisaient l’état clinique du patient dans la décision d’accès.
Mon projet de fin d’études de Master posait donc une seule question : peut-on placer les composants d’une architecture Zero Trust devant des dispositifs médicaux contraints sans ralentir les soins ?
Ma réponse s’appelle VIGIE. La vigie, c’est le poste d’observation qui surveille sans relâche. Le nom se lit aussi comme un acronyme : Vérification d’Identité et Gouvernance Intelligente des Échanges.
Des menaces à dix exigences
Je suis parti des menaces, classées avec la grille STRIDE : usurpation d’identité, rejeu de jetons, accès non autorisés et élévation de privilèges, attaques de l’homme du milieu, déni de service. J’y ai ajouté ce qu’imposent HIPAA et le RGPD pour les données de santé, comme la traçabilité des accès et la notification d’une violation sous 72 heures.
Le résultat tient en dix exigences numérotées, ES-01 à ES-10. Chacune renvoie à un choix de conception, puis à un module de code, puis à un test. Deux d’entre elles ne protègent rien à elles seules et décident pourtant si la solution est utilisable :
- ES-09 : aucun agent logiciel sur le dispositif, et une cryptographie légère de son côté.
- ES-10 : un surcoût de latence borné et mesuré sur un banc d’essai. Un framework qui violerait l’une de ces deux règles pourrait être sûr sur le papier et inutilisable au chevet du patient.
Un point d’entrée, quatre modules
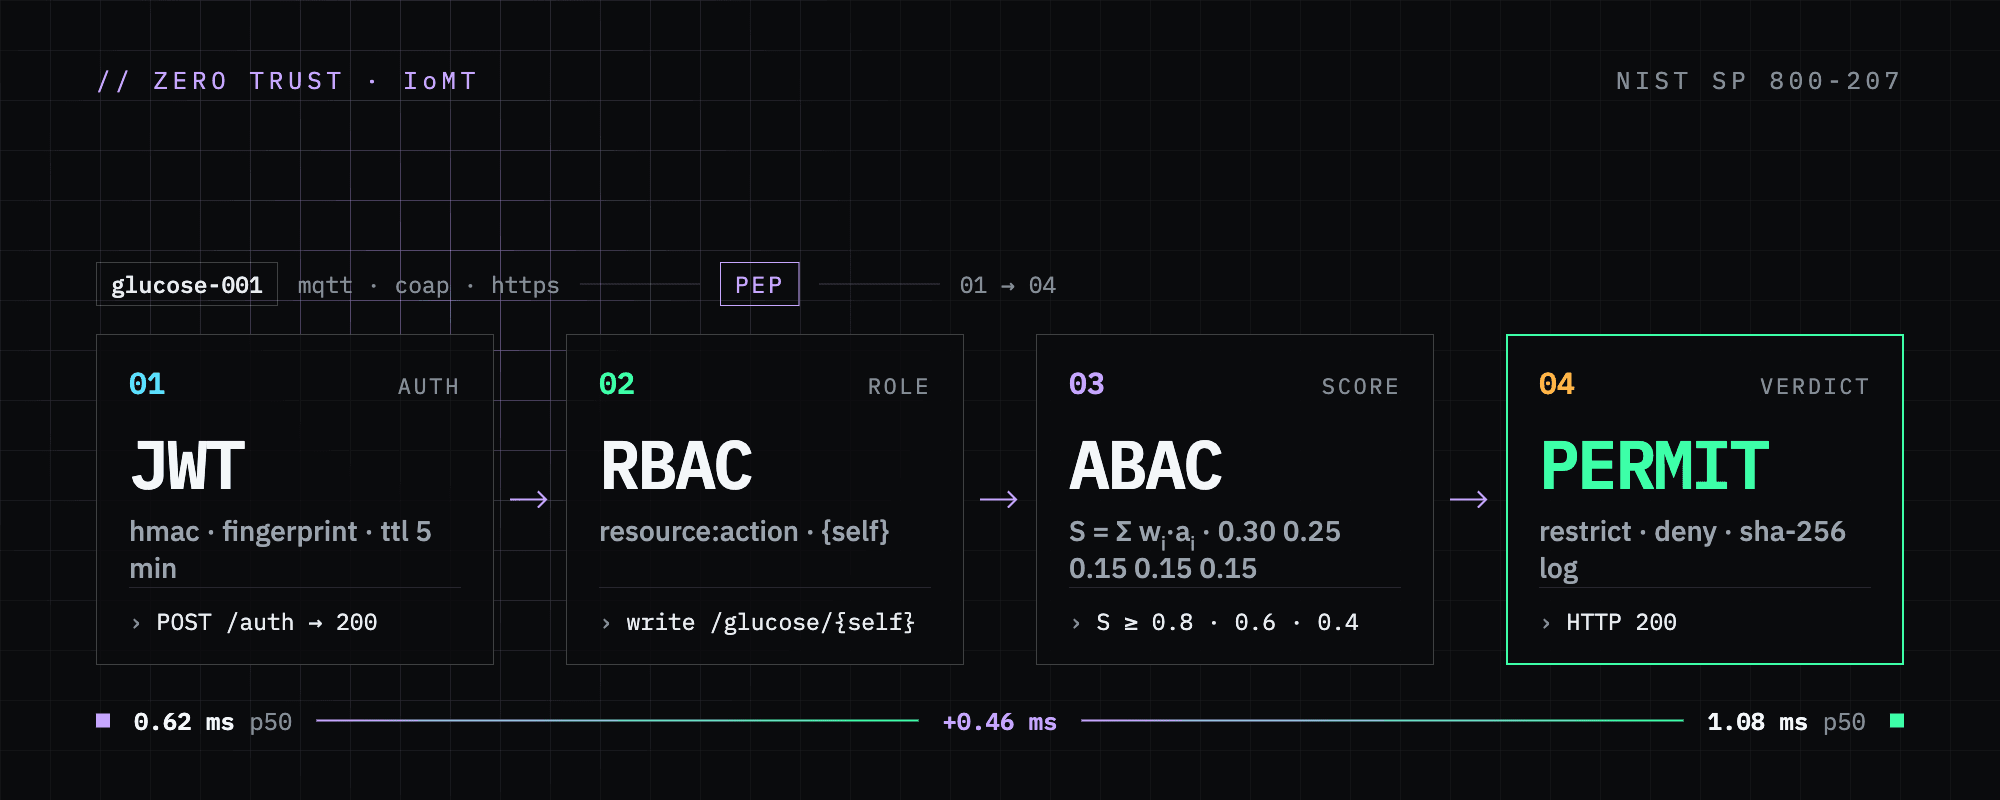
Toutes les requêtes des dispositifs passent par un point d’entrée unique, le point d’application des politiques (PEP) dans le vocabulaire du NIST. Derrière lui, quatre modules se partagent le travail :
| Module | Son rôle |
|---|---|
| Authentification | Prouve que le dispositif est bien celui qui a été enregistré, émet des jetons de courte durée |
| Moteur de politique | Décide de chaque requête à partir du rôle, des attributs et d’un score de confiance |
| Gestionnaire de contexte | Transforme la localisation, l’heure, le comportement, l’âge du jeton et l’état du patient en score |
| Surveillance | Journalise chaque décision, repère les anomalies, peut suspendre ou révoquer un dispositif |
D’où vient la première confiance
Les architectures à jetons laissent souvent cette question de côté. Dans VIGIE, la première confiance vient d’un enrôlement en quatre étapes, mené par l’administrateur de sécurité à la réception de chaque équipement :
- Confronter le numéro de série et la référence du fournisseur aux documents d’achat.
- Créer l’identité du dispositif : un
deviceIdet un secret (un certificat client si l’appareil peut le porter, une clé symétrique dédiée sinon), installé par un canal local, jamais par le réseau de production. - Enregistrer l’empreinte attendue : type, modèle, version du micrologiciel, protocole et passerelle.
- Attribuer un rôle selon la fonction clinique de l’équipement. L’authentification demande ensuite deux facteurs : la preuve de possession du secret et une empreinte conforme. Les dispositifs à certificat signent un défi. Ceux qui se limitent à la cryptographie symétrique calculent un HMAC sur un défi à usage unique, ce qui devrait prendre de quelques dizaines à quelques centaines de microsecondes sur un microcontrôleur 32 bits courant, pour quelques centaines d’octets de mémoire. C’est une estimation tirée des performances publiées de la primitive ; la mesure sur du vrai matériel fait partie de la suite.
Une authentification réussie renvoie un JWT valable 5 minutes, avec un identifiant unique (jti), le rôle du dispositif et sa portée d’action. La conception signe les jetons en RS256, pour que n’importe quel composant puisse vérifier un jeton sans pouvoir en émettre. Le prototype utilise HS256, une simplification documentée.
Les jetons de renouvellement tournent, et chacun ne sert qu’une fois. Si un attaquant en vole un et l’utilise, le vrai dispositif présentera tôt ou tard son exemplaire périmé. Cette double utilisation est impossible en fonctionnement normal : elle révoque toute la famille de jetons et déclenche une alerte. Le mécanisme de défense produit lui-même la preuve du vol.
Le statut du dispositif est aussi vérifié à chaque requête. Passer un dispositif en « suspect » rend tous ses jetons inopérants d’un coup, y compris ceux qui restent valides du point de vue cryptographique.
Décider de chaque requête
Le moteur de politique enchaîne quatre contrôles dans un ordre fixe : le jeton, le rôle (RBAC), les conditions sur les attributs (ABAC), puis le score de confiance face au seuil de la ressource. Tout ce qui n’est pas explicitement autorisé est refusé, et le premier refus arrête l’évaluation. Les contrôles les moins coûteux passent en premier, donc les requêtes manifestement illégitimes sont rejetées au moindre coût, ce qui aide aussi face à un afflux de requêtes.
Les rôles suivent le principe du moindre privilège, avec une règle qui compte beaucoup : un capteur de glycémie peut écrire des mesures de glycémie, mais seulement les siennes. Sans cette restriction, un seul capteur compromis pourrait falsifier les mesures de tous les patients. Le rôle d’administrateur de sécurité gère les politiques et révoque les dispositifs, sans aucun accès aux données cliniques.
L’ABAC ajoute les circonstances. Un infirmier, par exemple, ne lit les mesures que pendant sa plage de service et depuis le réseau de l’établissement.
Le score de confiance est une somme pondérée de cinq attributs, chacun noté entre 0 et 1 :
| Attribut | Poids |
|---|---|
| Comportement récent (cadence, volume, échecs récents) | 0,30 |
| Localisation réseau | 0,25 |
| Cohérence horaire avec le profil habituel | 0,15 |
| Fraîcheur de l’authentification | 0,15 |
| Conformité de l’empreinte | 0,15 |
Le comportement pèse le plus lourd parce que c’est le signal de compromission le plus précoce et le plus difficile à contrefaire. Chaque ressource a son propre seuil : 0,8 pour le dossier patient, 0,6 pour l’écriture de mesures, 0,4 pour la lecture de référentiels techniques.
La décision a trois issues. Entre PERMIT et DENY, il existe RESTRICT : quand le score tombe juste sous le seuil (à moins de 0,15), une lecture reste possible sous une forme réduite, et une alerte de faible gravité part. Un capteur qui s’écarte un peu de son profil est plus probablement défaillant que piraté, et le couper reviendrait à perdre le monitorage d’un patient sur un simple soupçon.
Voici le cœur de cette décision dans le prototype (version abrégée) :
authorize({ subject, role, action, resource, ctx = {} }) {
  // Étape 2 : RBAC (le jeton a déjà été validé par le middleware du PEP)
  if (!this._rbacAllows(role, resource, action, subject, ctx))
    return { decision: 'DENY', reason: 'rbac_refus', http: 403 };

  // Étape 3 : conditions ABAC
  const abac = ABAC[role];
  if (abac && !abac({ ...ctx, action }))
    return { decision: 'DENY', reason: 'abac_refus', http: 403 };

  // Étape 4 : score contextuel face au seuil de la ressource
  const scoreRes = this.context.computeScore(subject, ctx);
  let threshold = this._thresholdFor(resource);
  if (ctx.patientState === 'critical') { // modulation clinique
    if (action === 'read') threshold = Math.max(0.3, threshold - 0.2);
    if (action === 'write' || action === 'command')
      threshold = Math.min(0.95, threshold + 0.1);
  }

  if (scoreRes.score >= threshold)
    return { decision: 'PERMIT', score: scoreRes.score, breakdown: scoreRes.breakdown };
  if (scoreRes.score >= threshold - config.trust.degradedMargin && action === 'read')
    return { decision: 'RESTRICT', score: scoreRes.score, restricted: true, http: 200 };
  return { decision: 'DENY', reason: 'score_insuffisant', score: scoreRes.score, http: 403 };
}
Chaque décision est journalisée avec le détail complet de son score : un refus peut toujours être expliqué à un administrateur ou à un auditeur.
L’état du patient change les règles
Les lignes patientState ci-dessus sont la partie de VIGIE à laquelle je tiens le plus. Quand le système d’information signale un patient en état critique, deux seuils bougent en sens inverse :
- Le personnel soignant lit plus facilement les données de ce patient, même en dehors de ses horaires habituels (le seuil baisse de 0,2). C’est une règle de bris de glace : chaque utilisation est journalisée avec un marqueur dédié et déclenche une notification.
- Les commandes envoyées aux actionneurs, comme la modification d’une consigne de pompe, deviennent plus difficiles à faire passer (le seuil monte de 0,1). En urgence, lire vite les données fait gagner du temps, alors qu’une commande de pompe falsifiée peut tuer. Le framework doit faciliter l’un et durcir l’autre au même instant.
Surveiller, et agir sur ce qu’on voit
Chaque événement de sécurité produit une entrée JSON : horodatage, dispositif, action, ressource, décision, détail du score, motif, adresse d’origine et identifiant du jeton. Chaque entrée contient aussi l’empreinte SHA-256 de la précédente. Modifier ou supprimer une ancienne entrée casse donc la chaîne, et une simple vérification linéaire le détecte. L’écriture est asynchrone : la journalisation ne prend rien sur le budget de latence.
Le module d’alerte lit ce même flux de journaux et applique des règles à fenêtre glissante :
| Règle | Condition | Action |
|---|---|---|
| R1 | 5 échecs d’authentification en 60 s pour un même dispositif | Dispositif suspendu, alerte |
| R2 | Présentation d’un jeton révoqué | Alerte immédiate, origine marquée pour examen |
| R3 | Réutilisation d’un jti (rejeu) | Dispositif révoqué, alerte |
| R4 | Réutilisation d’un jeton de renouvellement | Famille de jetons révoquée, alerte |
| R5 | Volume de requêtes supérieur à 3 fois le profil du dispositif | Score de comportement dégradé, alerte |
| R6 | Requêtes répétées hors du rôle | Score de comportement dégradé, alerte |
Les actions automatiques sont réservées aux signaux qui produisent peu de fausses alertes et qui coûtent cher si l’on ne fait rien. Un dispositif suspendu peut être rétabli par l’administrateur, parce qu’une fausse alerte ne doit pas retirer longtemps un équipement médical du service. Un dispositif révoqué ne revient que par un nouvel enrôlement complet, avec un nouveau secret.
Ce que les tests ont montré
Le prototype tourne sur Node.js 20, dans un seul processus. Un second processus Node.js joue les capteurs et l’attaquant, et parle au framework par les mêmes interfaces réseau qu’un vrai dispositif. J’ai écrit 11 tests, chacun rattaché à une exigence, avec un résultat attendu vérifié automatiquement :
| Test | Scénario | Attendu | Résultat |
|---|---|---|---|
| T1 | Authentification légitime à deux facteurs | Jeton émis | Réussi |
| T2 | Usurpation avec une preuve forgée | HTTP 401 | Réussi |
| T3 | Empreinte de dispositif non conforme | HTTP 401 | Réussi |
| T4 | Capteur qui tente une lecture (hors de son rôle) | HTTP 403 | Réussi |
| T5 | Écriture pour le compte d’un autre dispositif | HTTP 403 | Réussi |
| T6 | Plusieurs signaux contextuels faibles cumulés | HTTP 403 | Réussi |
| T7 | Force brute (6 échecs) | Dispositif suspendu | Réussi |
| T8 | Authentification du dispositif suspendu | HTTP 401 | Réussi |
| T9 | Requête sans jeton | HTTP 401 | Réussi |
| T10 | Jeton falsifié | HTTP 401 | Réussi |
| T11 | Requête légitime normale | HTTP 200, PERMIT | Réussi |
T7 et T8 montrent ensemble la boucle fermée : le dispositif suspendu par la règle R1 est refusé ensuite, même avec des identifiants qui seraient encore valides.
Pour la latence, j’ai comparé une écriture qui traverse toute la chaîne (jeton, RBAC, ABAC, score, journalisation) à un point d’accès de référence sans aucun contrôle. Trois exécutions de 3 000 requêtes chacune, après 50 requêtes d’échauffement :
| Latence | Sans VIGIE | Avec VIGIE | Surcoût |
|---|---|---|---|
| Médiane | 0,62 ms | 1,08 ms | 0,46 ms |
| Moyenne | 0,86 ms | 1,53 ms | 0,67 ms |
| 95e percentile | 1,22 ms | 3,60 ms | 2,38 ms |
| 99e percentile | 8,97 ms | 11,32 ms | 2,35 ms |
En valeur relative, la médiane augmente d’environ 75 %, ce qui paraît lourd. En valeur absolue, c’est moins d’une demi-milliseconde, sur une référence qui ne fait presque rien. Une télésurveillance compte habituellement sa latence en dizaines ou en centaines de millisecondes dès qu’un vrai réseau est traversé : un surcoût inférieur à la milliseconde y passe inaperçu.
Sous 5 000 requêtes concurrentes, le processus unique, sans optimisation, a traité environ 600 à 700 requêtes par seconde. Un capteur de télémétrie publie environ une fois par seconde, donc une instance peut servir plusieurs centaines de dispositifs. Les jetons sont validés localement, sans état partagé : on peut placer plusieurs instances derrière un répartiteur de charge.
J’ai aussi testé la chaîne du journal. L’outil de vérification intégré a confirmé toutes les entrées, y compris sous écriture concurrente. Après la modification volontaire d’une entrée, la vérification a pointé exactement cette position.
Le test qui a trouvé un bug
T6 n’est pas passé comme je l’avais écrit au départ. Je m’attendais à ce qu’une simple écriture depuis un réseau inconnu soit refusée. Elle a été acceptée : le dispositif était authentifié, son comportement était régulier et son empreinte conforme, donc son score restait au-dessus du seuil.
Ce comportement était le bon. Un signal isolé ne doit pas couper un dispositif médical légitime. Le test combine maintenant un réseau inconnu, un horaire atypique et un volume anormal, et cette combinaison est refusée.
En creusant, j’ai aussi trouvé un vrai défaut. À cause d’une correspondance de préfixe ambiguë, les requêtes d’écriture recevaient le seuil plus bas prévu pour la lecture. Je l’ai corrigé, et c’est pour ça que je préfère les tests qui s’exécutent contre le vrai système : un test qui se contente de confirmer les attentes du concepteur n’apprend rien.
Ce que ce travail ne prouve pas encore
› NOTE
VIGIE est une preuve de concept, testée en environnement contrôlé. Ces limites font partie du résultat.
- Les dispositifs, les attaques et le réseau sont simulés, et la latence a été mesurée en HTTP sur la boucle locale : les valeurs absolues seront plus élevées sur un vrai réseau.
- TLS n’était pas activé sur le banc d’essai, donc le chiffrement du transport (ES-05) reste une exigence de déploiement, non vérifiée ici.
- Les règles de rejeu (R3, R4) et de saturation (R5) sont implémentées, mais n’ont pas encore eu de scénario de test dédié.
- Les poids et les seuils du score sont des valeurs raisonnées, pas calibrées sur des données de terrain. Ce sont des paramètres de configuration : un déploiement pilote pourrait les ajuster sans toucher au code.
- J’ai écrit moi-même les attaques contre mon propre système. Un audit externe ou une analyse automatisée serait l’étape suivante honnête.
- Le prototype signe les jetons en HS256 au lieu du RS256 prévu par la conception, et je n’ai pas comparé VIGIE chiffres à l’appui avec les systèmes proches.
Ce que je construirais ensuite
Les premières étapes sont déjà cadrées : brancher un vrai courtier MQTT et un point d’accès CoAP, exécuter les scénarios de rejeu et de saturation, et activer TLS pour que ES-05 devienne une propriété testée. Ensuite, seul un déploiement pilote avec de vrais dispositifs permettra de calibrer le score de confiance et de mesurer les fausses alertes. Les règles à fenêtre glissante pourraient alors s’appuyer sur un modèle entraîné sur le trafic de chaque dispositif, pour distinguer un capteur défaillant d’un capteur compromis. Pour les plus petits dispositifs, Ascon, la cryptographie légère normalisée par le NIST dans la publication SP 800-232, permettrait d’étendre l’authentification forte à des capteurs qui peinent aujourd’hui à calculer un HMAC.